Operaciones diarias
Tareas que los operadores de MSSP ejecutan contra una instalación activa de SocTalk. Si aún no lo has hecho, lee primero el Recorrido por la UI de MSSP: cataloga cada página referenciada a continuación.
Cola de investigaciones
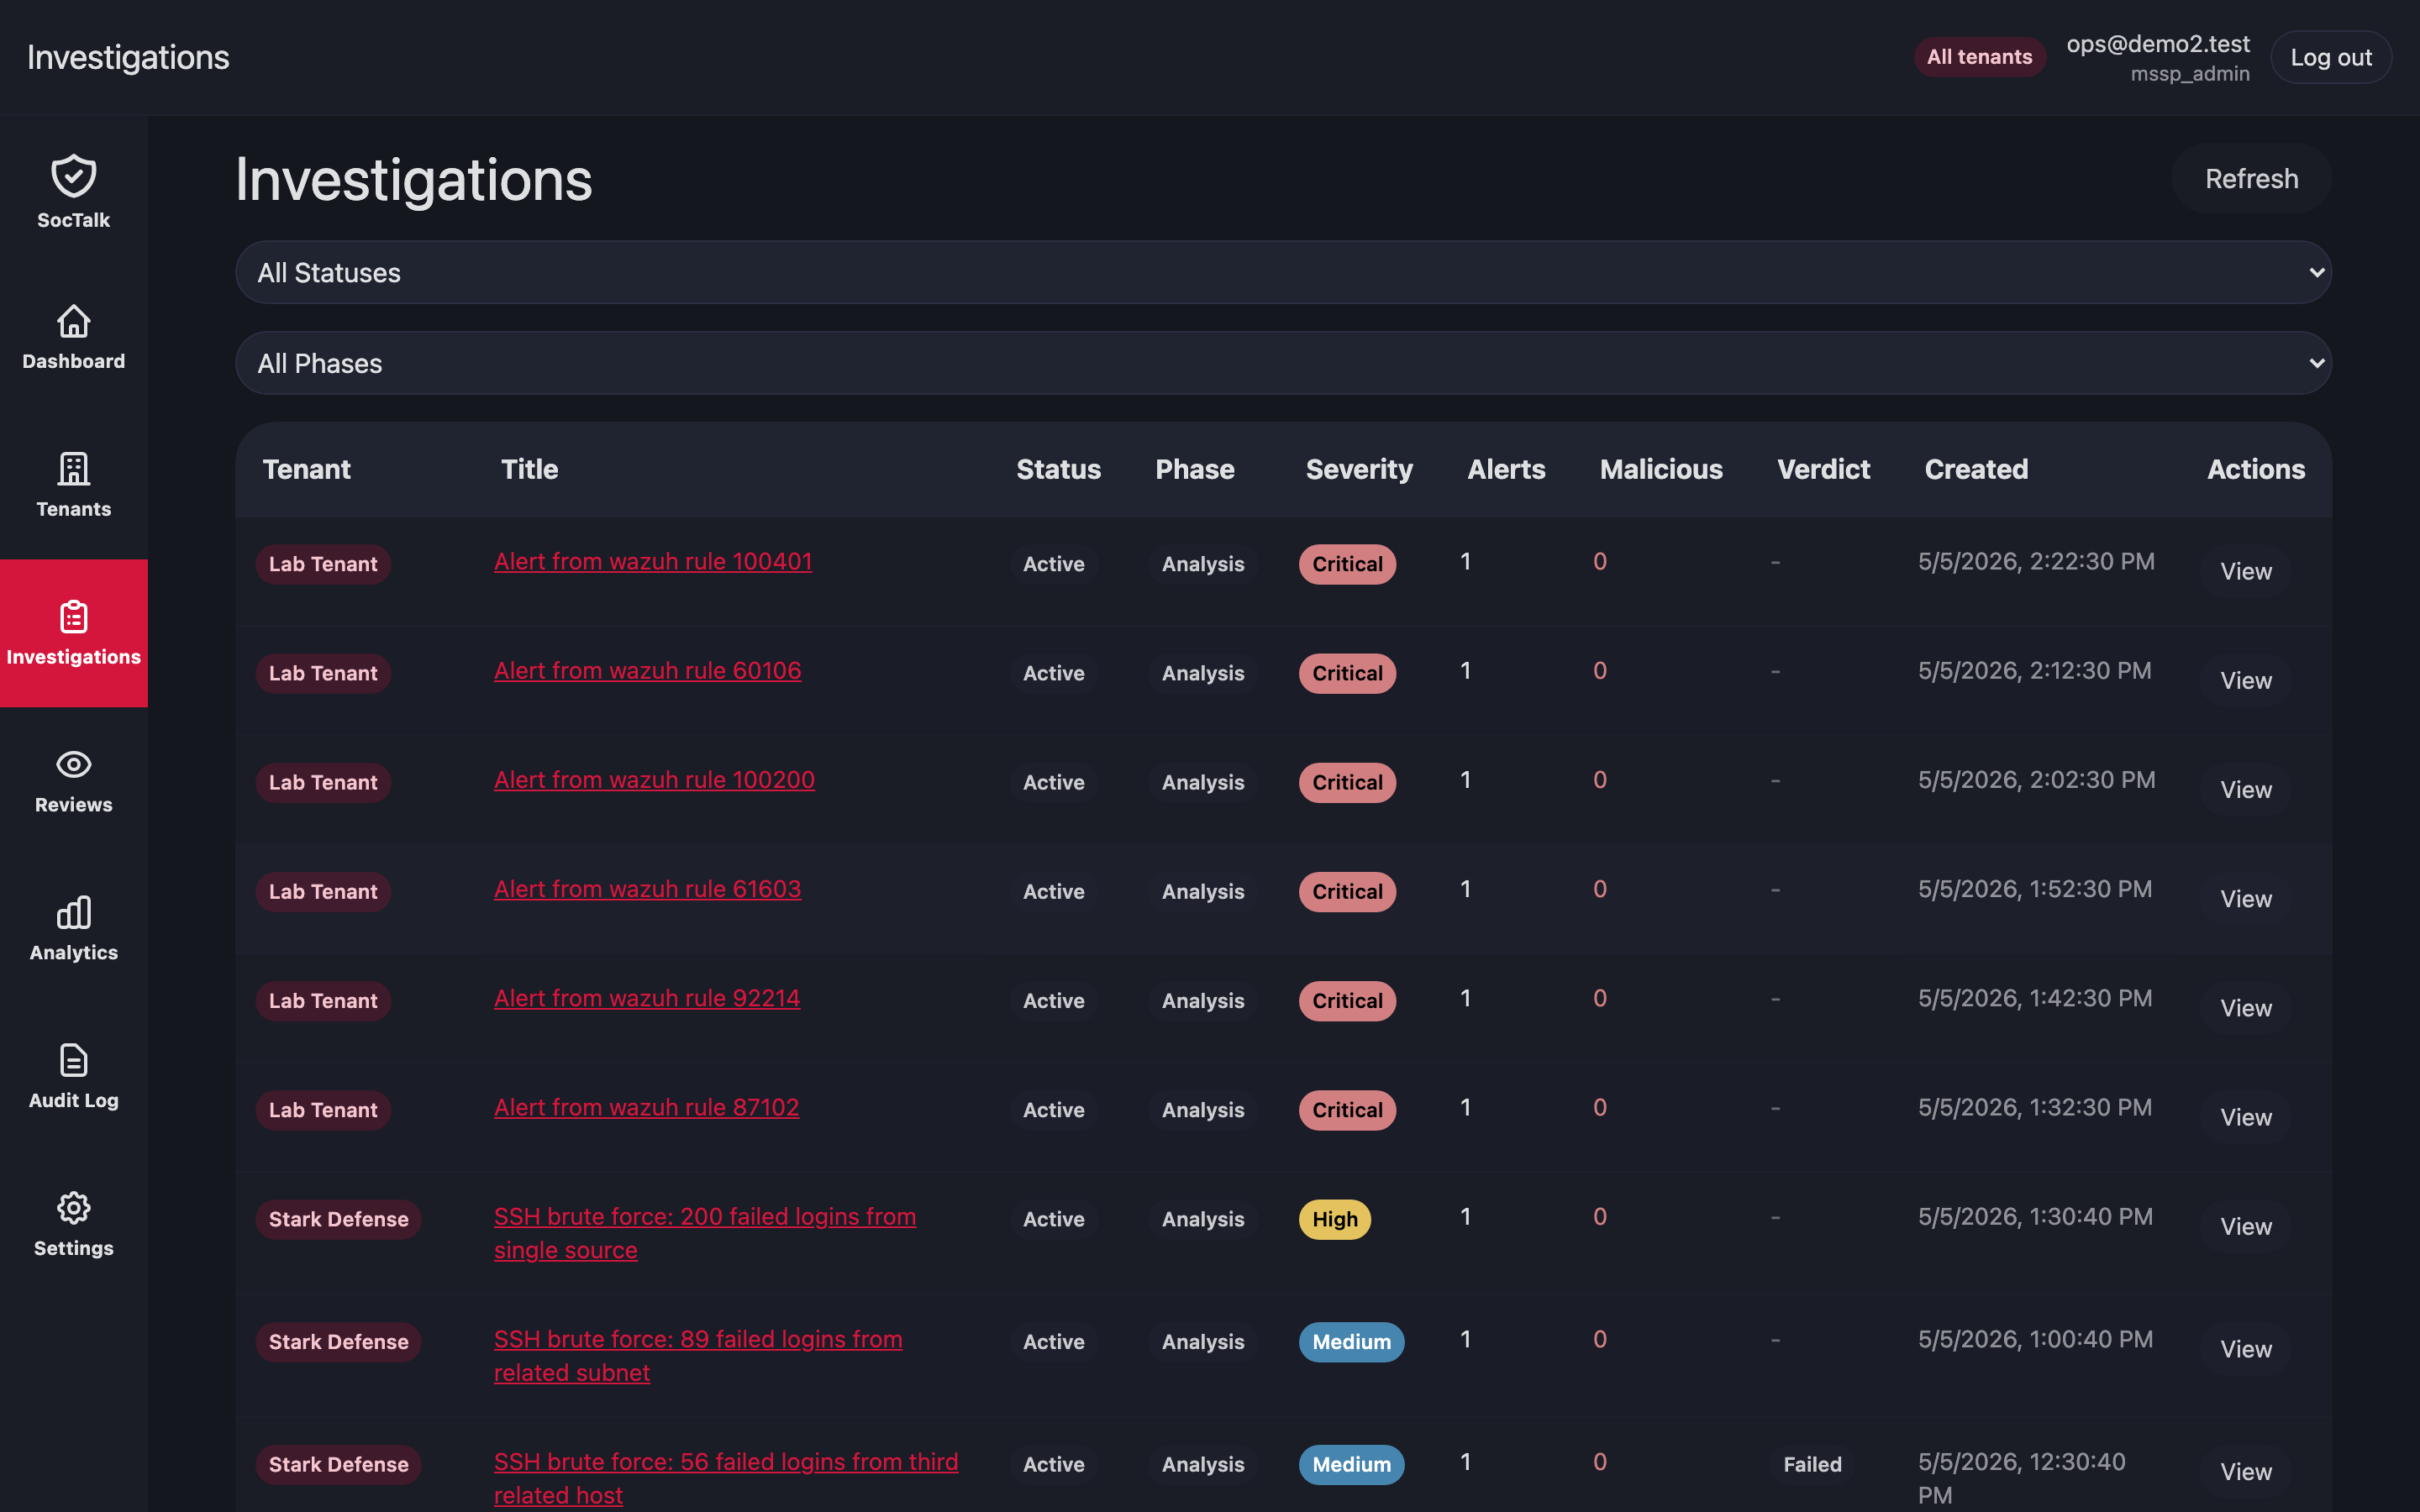
Abre Investigaciones para ver los casos activos de todos los tenants en una sola vista. Filtros: tenant, severidad. Haz clic en una fila para ver la línea de tiempo del caso, la conversación y las propuestas.
Cola de revisión de propuestas
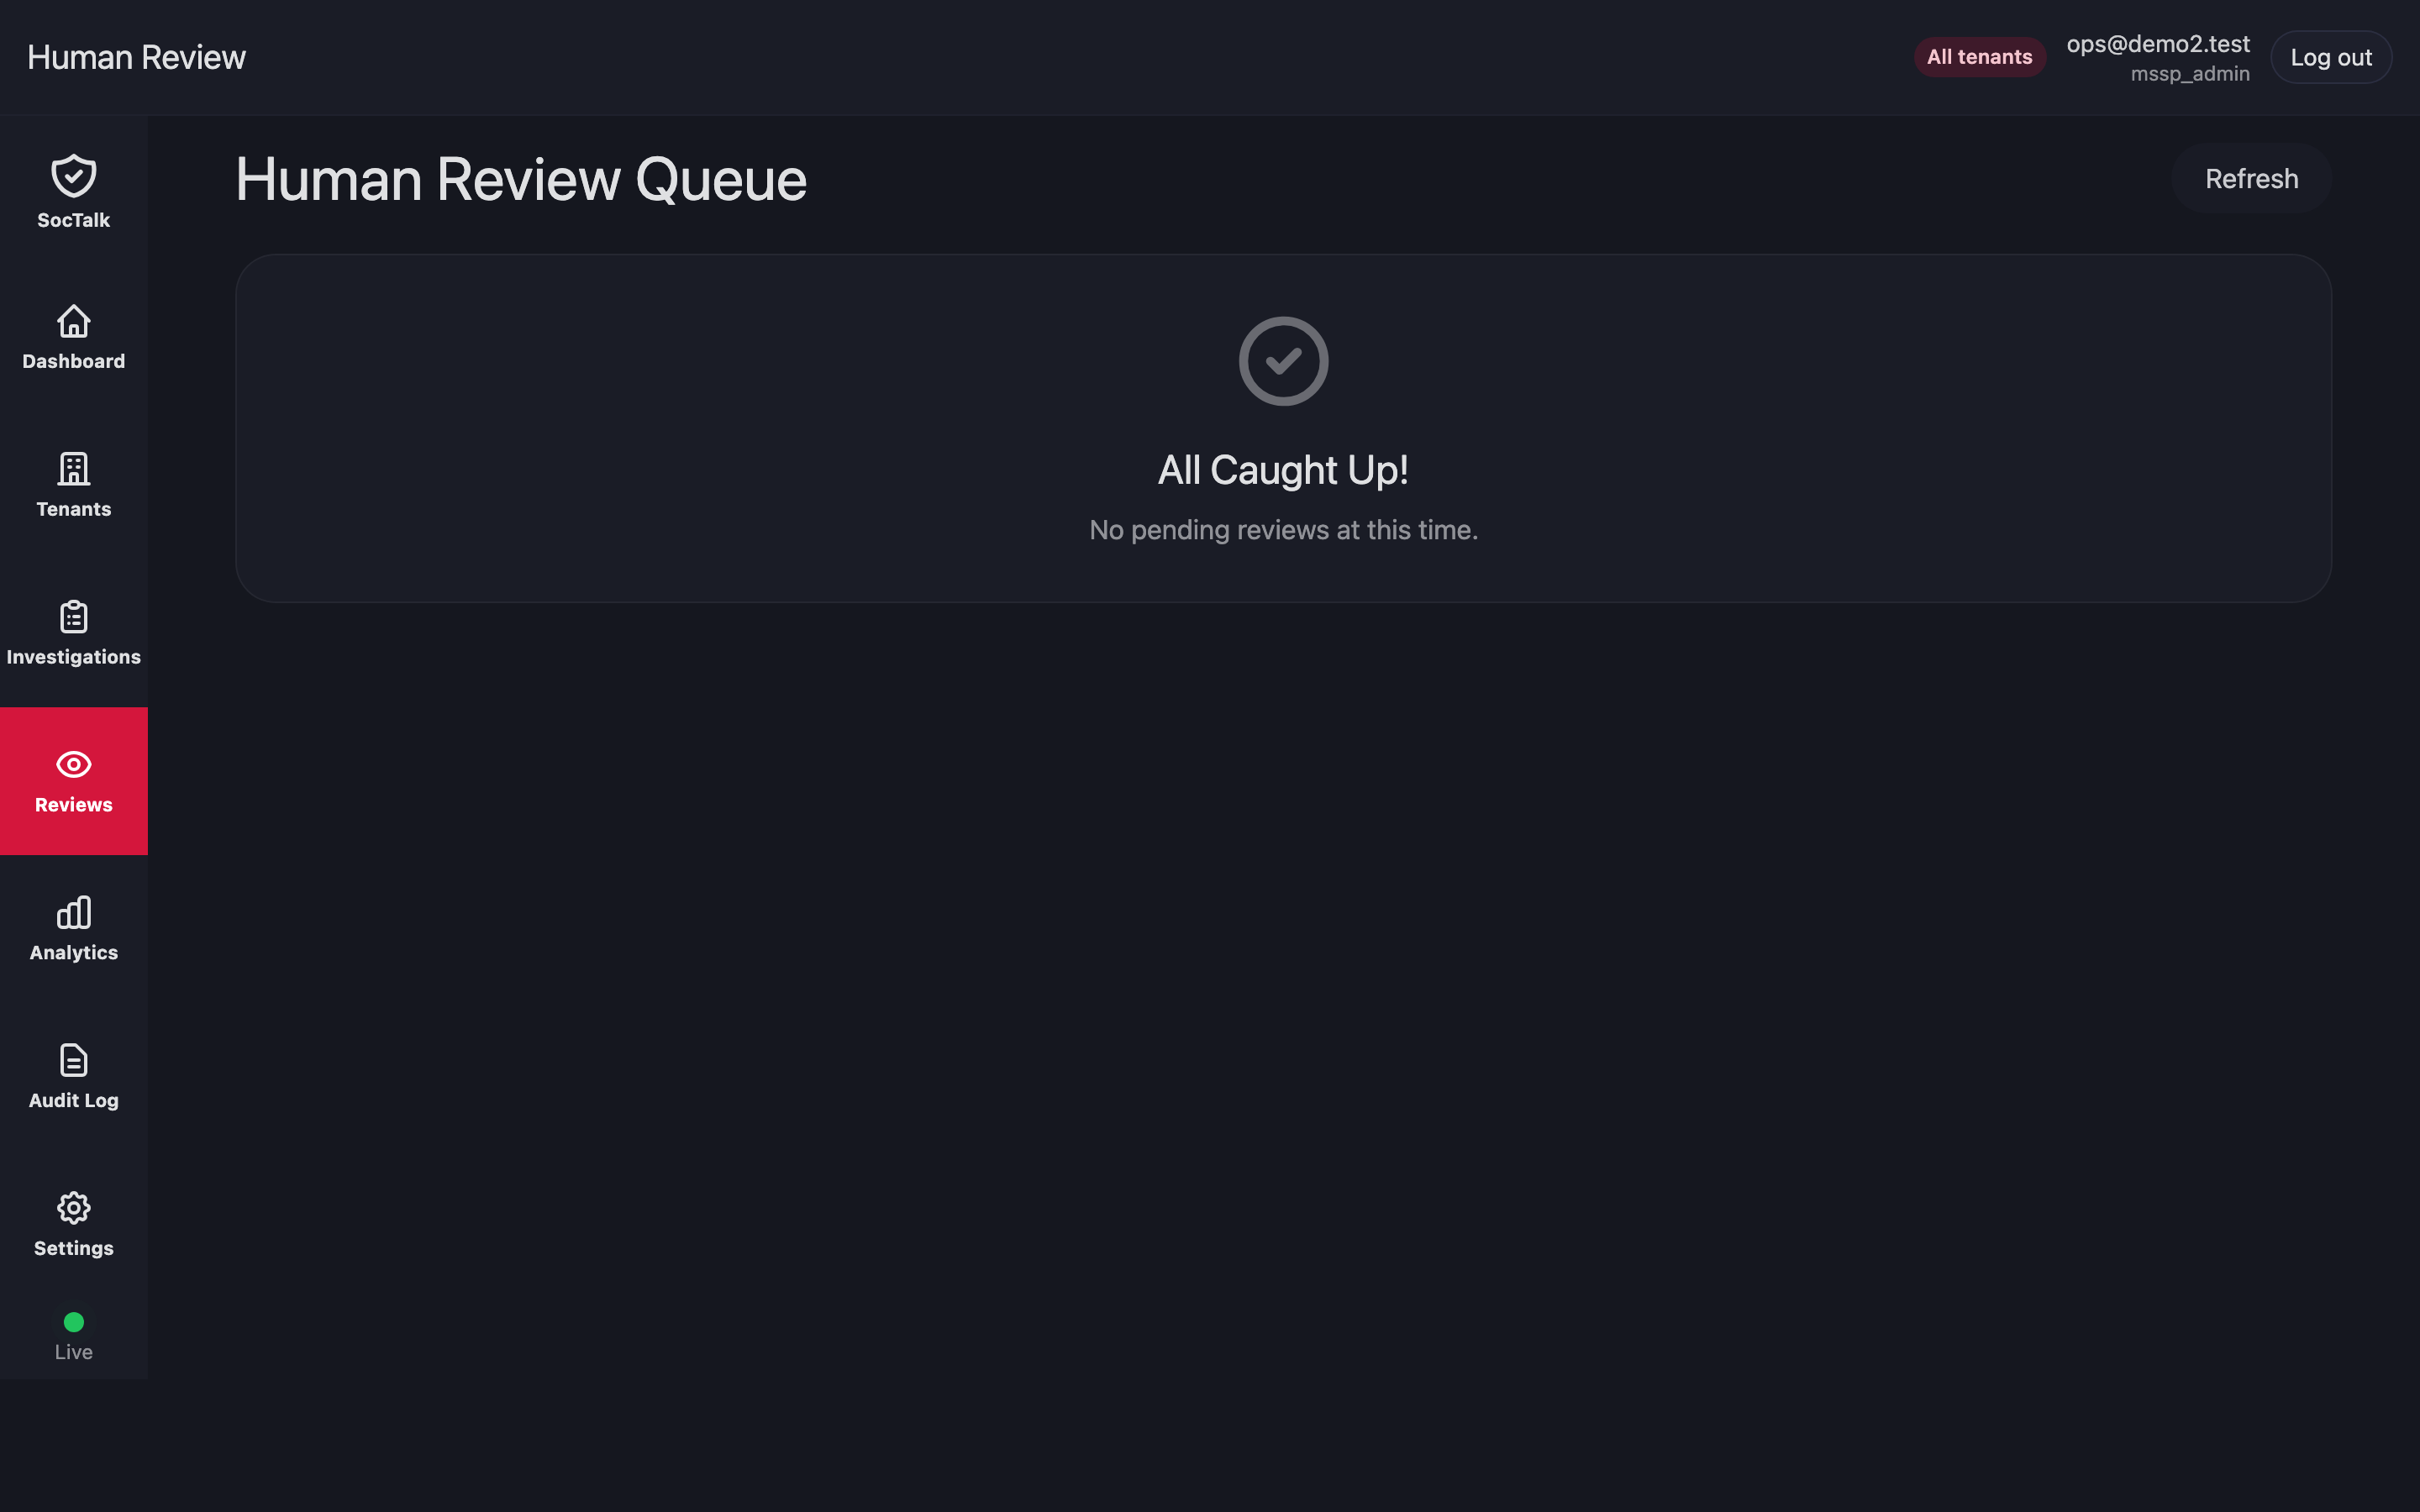
Revisiones es la cola multi-tenant de propuestas de la AI que esperan a una persona. Aprobar / rechazar / pedir-más-información actualiza cada uno la fila de revisión en la base de datos (y el registro de auditoría). No hay outbox en V1: el pipeline de ejecución / notificación aguas abajo está en la hoja de ruta.
Tenant atascado en provisioning
Síntoma: la fila del tenant de un cliente nuevo permanece en estado provisioning durante más de 15 min.
- Verifica el estado del release de Helm:bash
helm status tenant-<slug> -n tenant-<slug> - Verifica los eventos de los pods:bash
kubectl -n tenant-<slug> get events --sort-by=.lastTimestamp | tail -30 - Causas comunes:
StorageClassfaltante o provisioner caído → los PVCs quedan atascados enPending. Aprovisiona el almacenamiento;kubectl describe pvcmuestra el motivo.- ResourceQuota demasiado pequeño para la solicitud del indexador de Wazuh. Aumenta el ResourceQuota del tenant vía
helm upgradecon nuevos valores. - Fallos al extraer la imagen → verifica la autenticación del registry y el firewall.
Si un intento de aprovisionamiento no puede recuperarse, dá de baja y reintenta:
# Desde la UI de MSSP: detalle del tenant → Decommission → force=true
# O vía API:
curl -X POST https://mssp.../api/mssp/tenants/<id>:decommission?force=true
Tenant en estado degraded
El controlador de aprovisionamiento establece degraded ante un fallo de aprovisionamiento, o se establece explícitamente vía la API. En esta versión no hay un bucle de auto-degradación basado en la antigüedad del heartbeat del adaptador; la métrica soctalk_tenant_adapter_heartbeat_age_seconds es para tus alertas.
- Verifica el pod del adaptador:bash
kubectl -n tenant-<slug> logs deploy/soctalk-adapter --tail=200 - Verifica el egress de la NetworkPolicy (el adaptador necesita alcanzar la API de
soctalk-system):bashhubble observe --from-pod tenant-<slug>/soctalk-adapter-<pod> - Reinicia el adaptador:bash
kubectl -n tenant-<slug> rollout restart deploy/soctalk-adapter
Si el plano de datos está sano pero el adaptador aún no puede alcanzar soctalk-system, inspecciona la NetworkPolicy adapter-egress.
Rotar la clave de LLM por tenant
- Admin de MSSP → detalle del cliente → Settings → LLM → pega la nueva clave → Save (o
PATCH /api/mssp/tenants/{id}/llm). - El almacén autoritativo de SocTalk es
IntegrationConfig.llm_api_key_plainen Postgres. El controlador de aprovisionamiento materializa ese valor enSecret/tenant-llm-keyen el namespace del tenant (montado por el Deployment del runs-worker) y opcionalmente refleja una referencia ensoctalk-system/<tenant-id>-llmpara auditoría. - SocTalk reinicia con mejor esfuerzo el Deployment
soctalk-runs-workerentenant-<slug>para que la nueva clave surta efecto en la siguiente toma de investigación.
Rotar los secretos de arranque del plano de datos
En esta versión no existe un comando soctalk-cli rotate-*; esa ruta se documentó en borradores anteriores. Hoy:
- Contraseña de admin de Wazuh: parchea el Secret correspondiente en el namespace del tenant y luego reinicia el pod afectado. La reejecución del arranque del chart al iniciar el pod tomará la nueva credencial. TheHive y Cortex son integraciones externas, no subcharts empaquetados, así que sus credenciales se rotan en esos sistemas y se actualizan mediante la configuración de la integración (consulta /es-419/integrate/thehive, /es-419/integrate/cortex).
- Secreto compartido
authdde Wazuh: parcheaSecret/wazuh-authd-secretentenant-<slug>, reinicia el manager de Wazuh. Todos los agentes existentes deben reinscribirse con el nuevo secreto; distribúyelo por tu canal seguro habitual.
Un CLI envoltorio para estas rotaciones está en la hoja de ruta.
Analítica
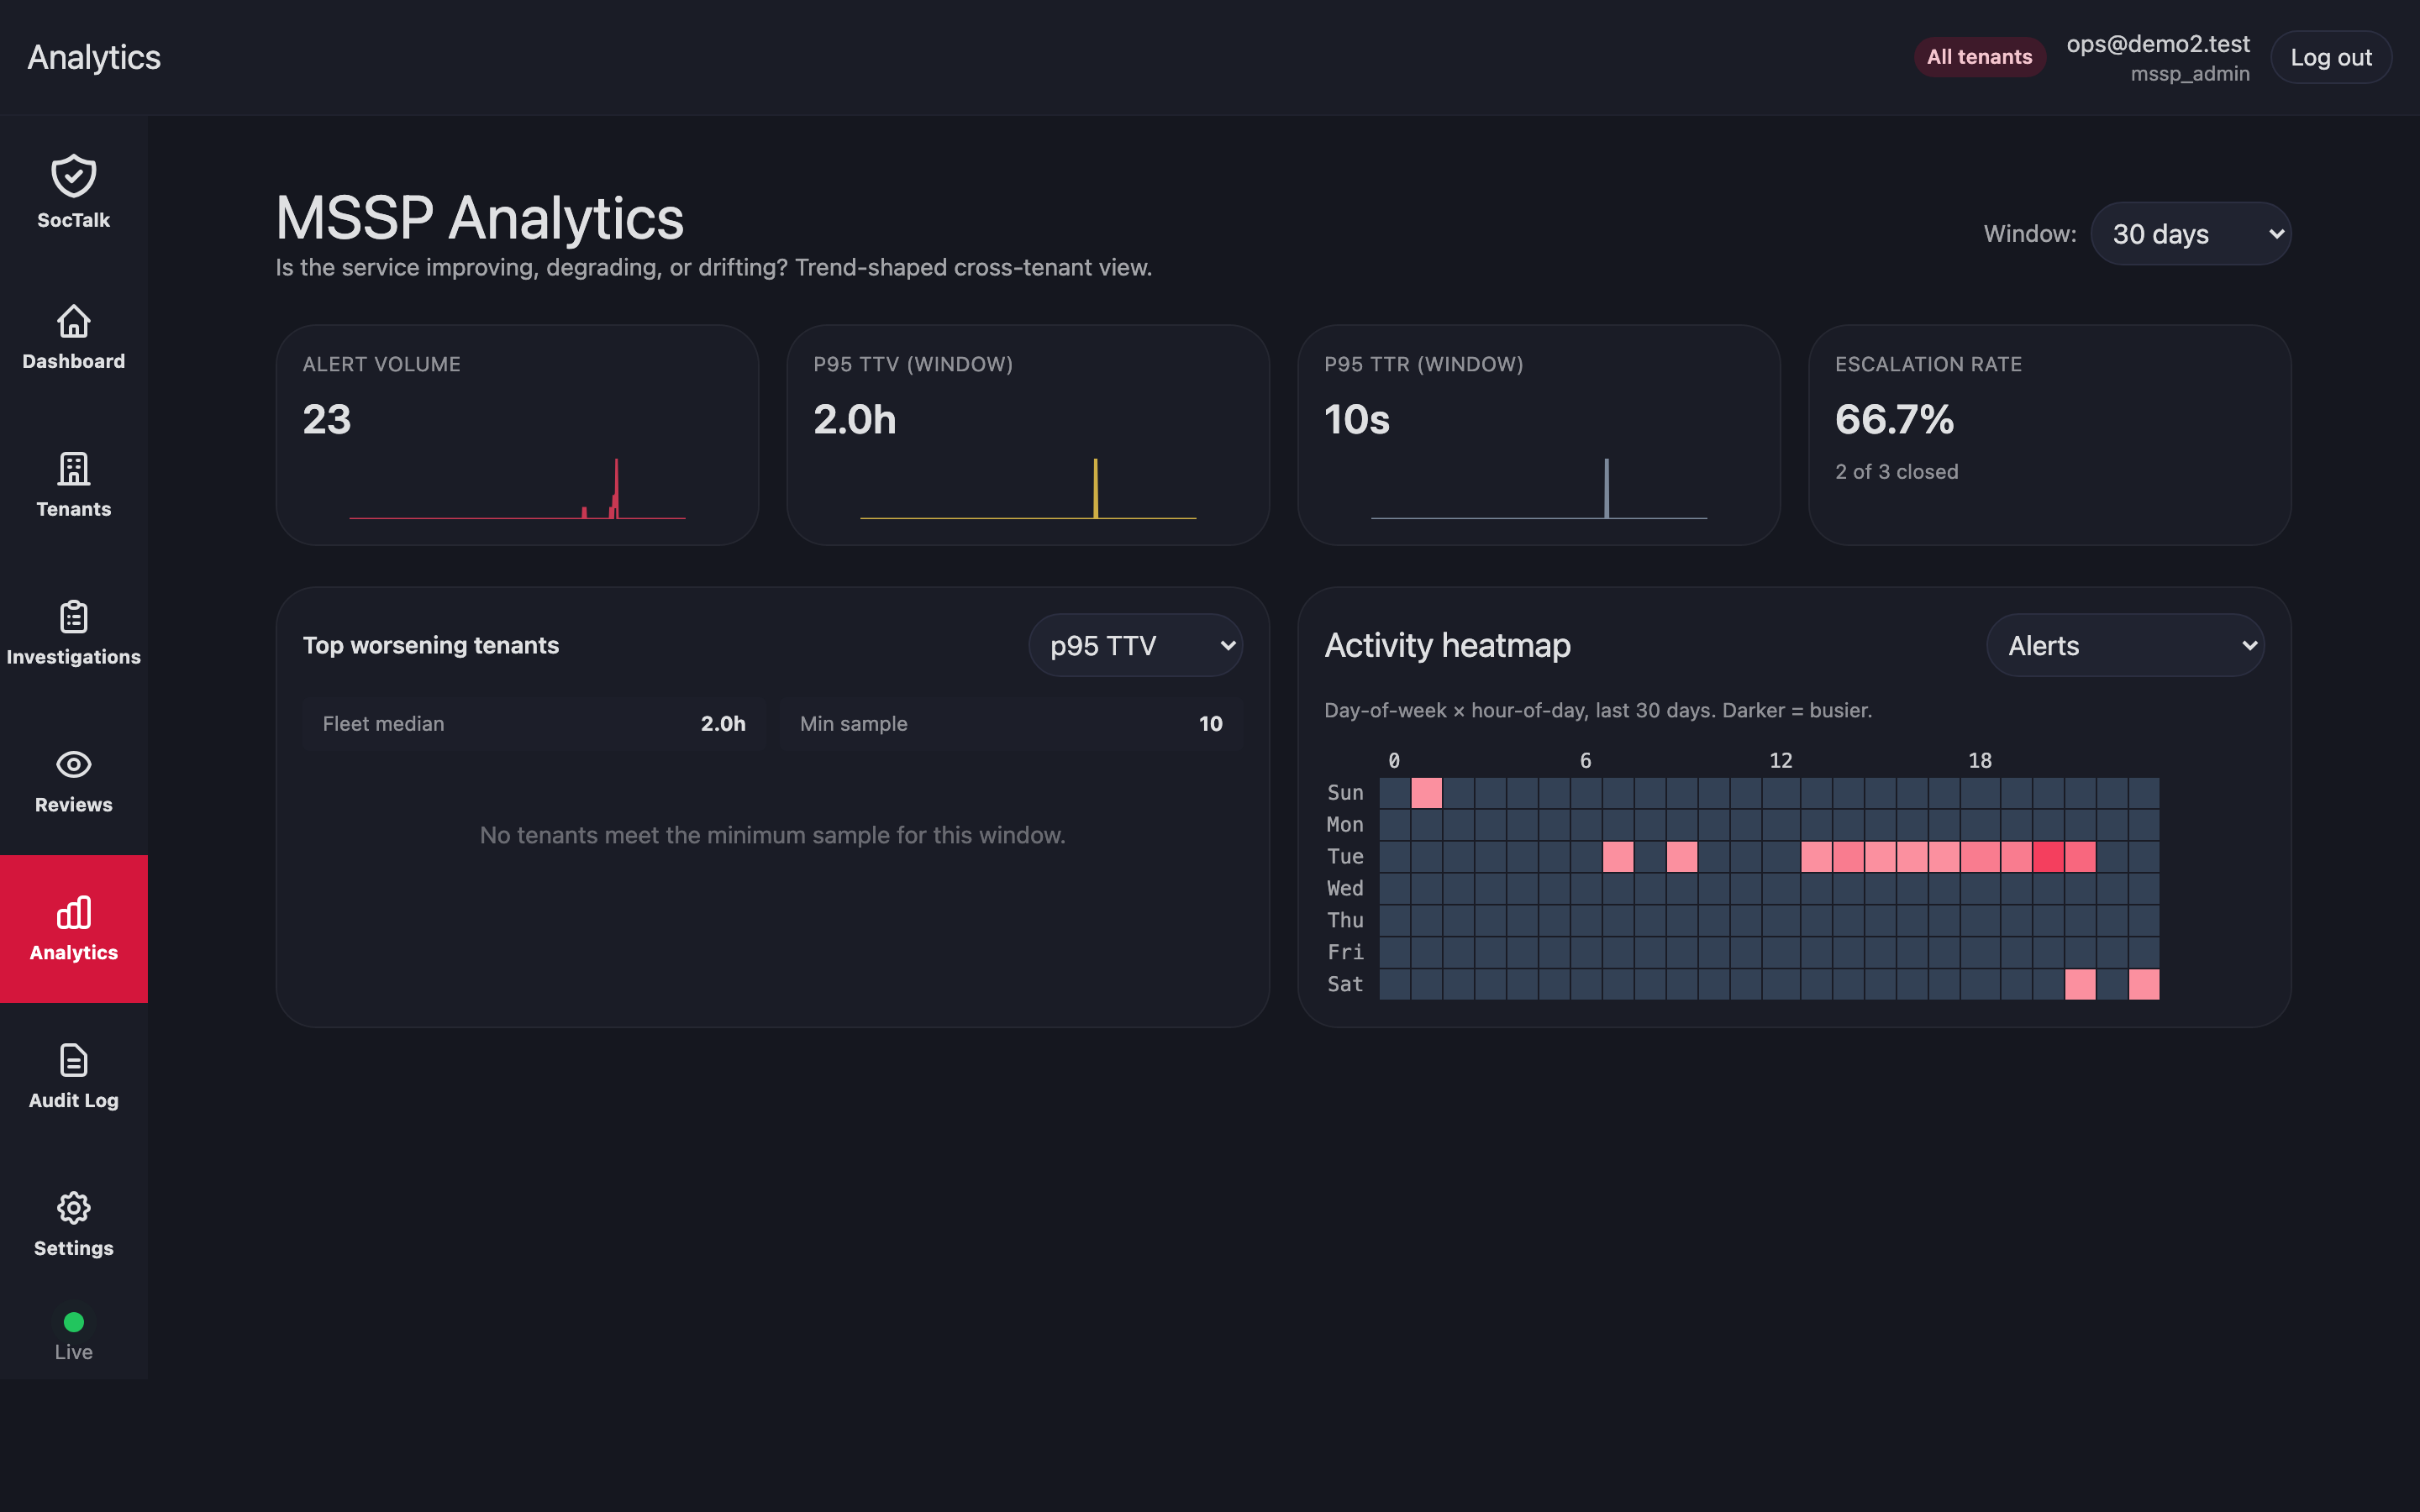
Analítica consolida el volumen de triaje, los resultados de propuestas, MTTR y el consumo de presupuesto por tenant. Úsala para planificación de capacidad, evaluación de modelos y revisión de SLA.
Revisión del registro de auditoría
El registro de auditoría de todo el MSSP vive en UI → pestaña Audit. Filtra por tenant, actor, acción o marca de tiempo. Para exportaciones de cumplimiento, usa la API:
curl 'https://mssp.../api/audit?since=2026-01-01&tenant=<id>' > audit.json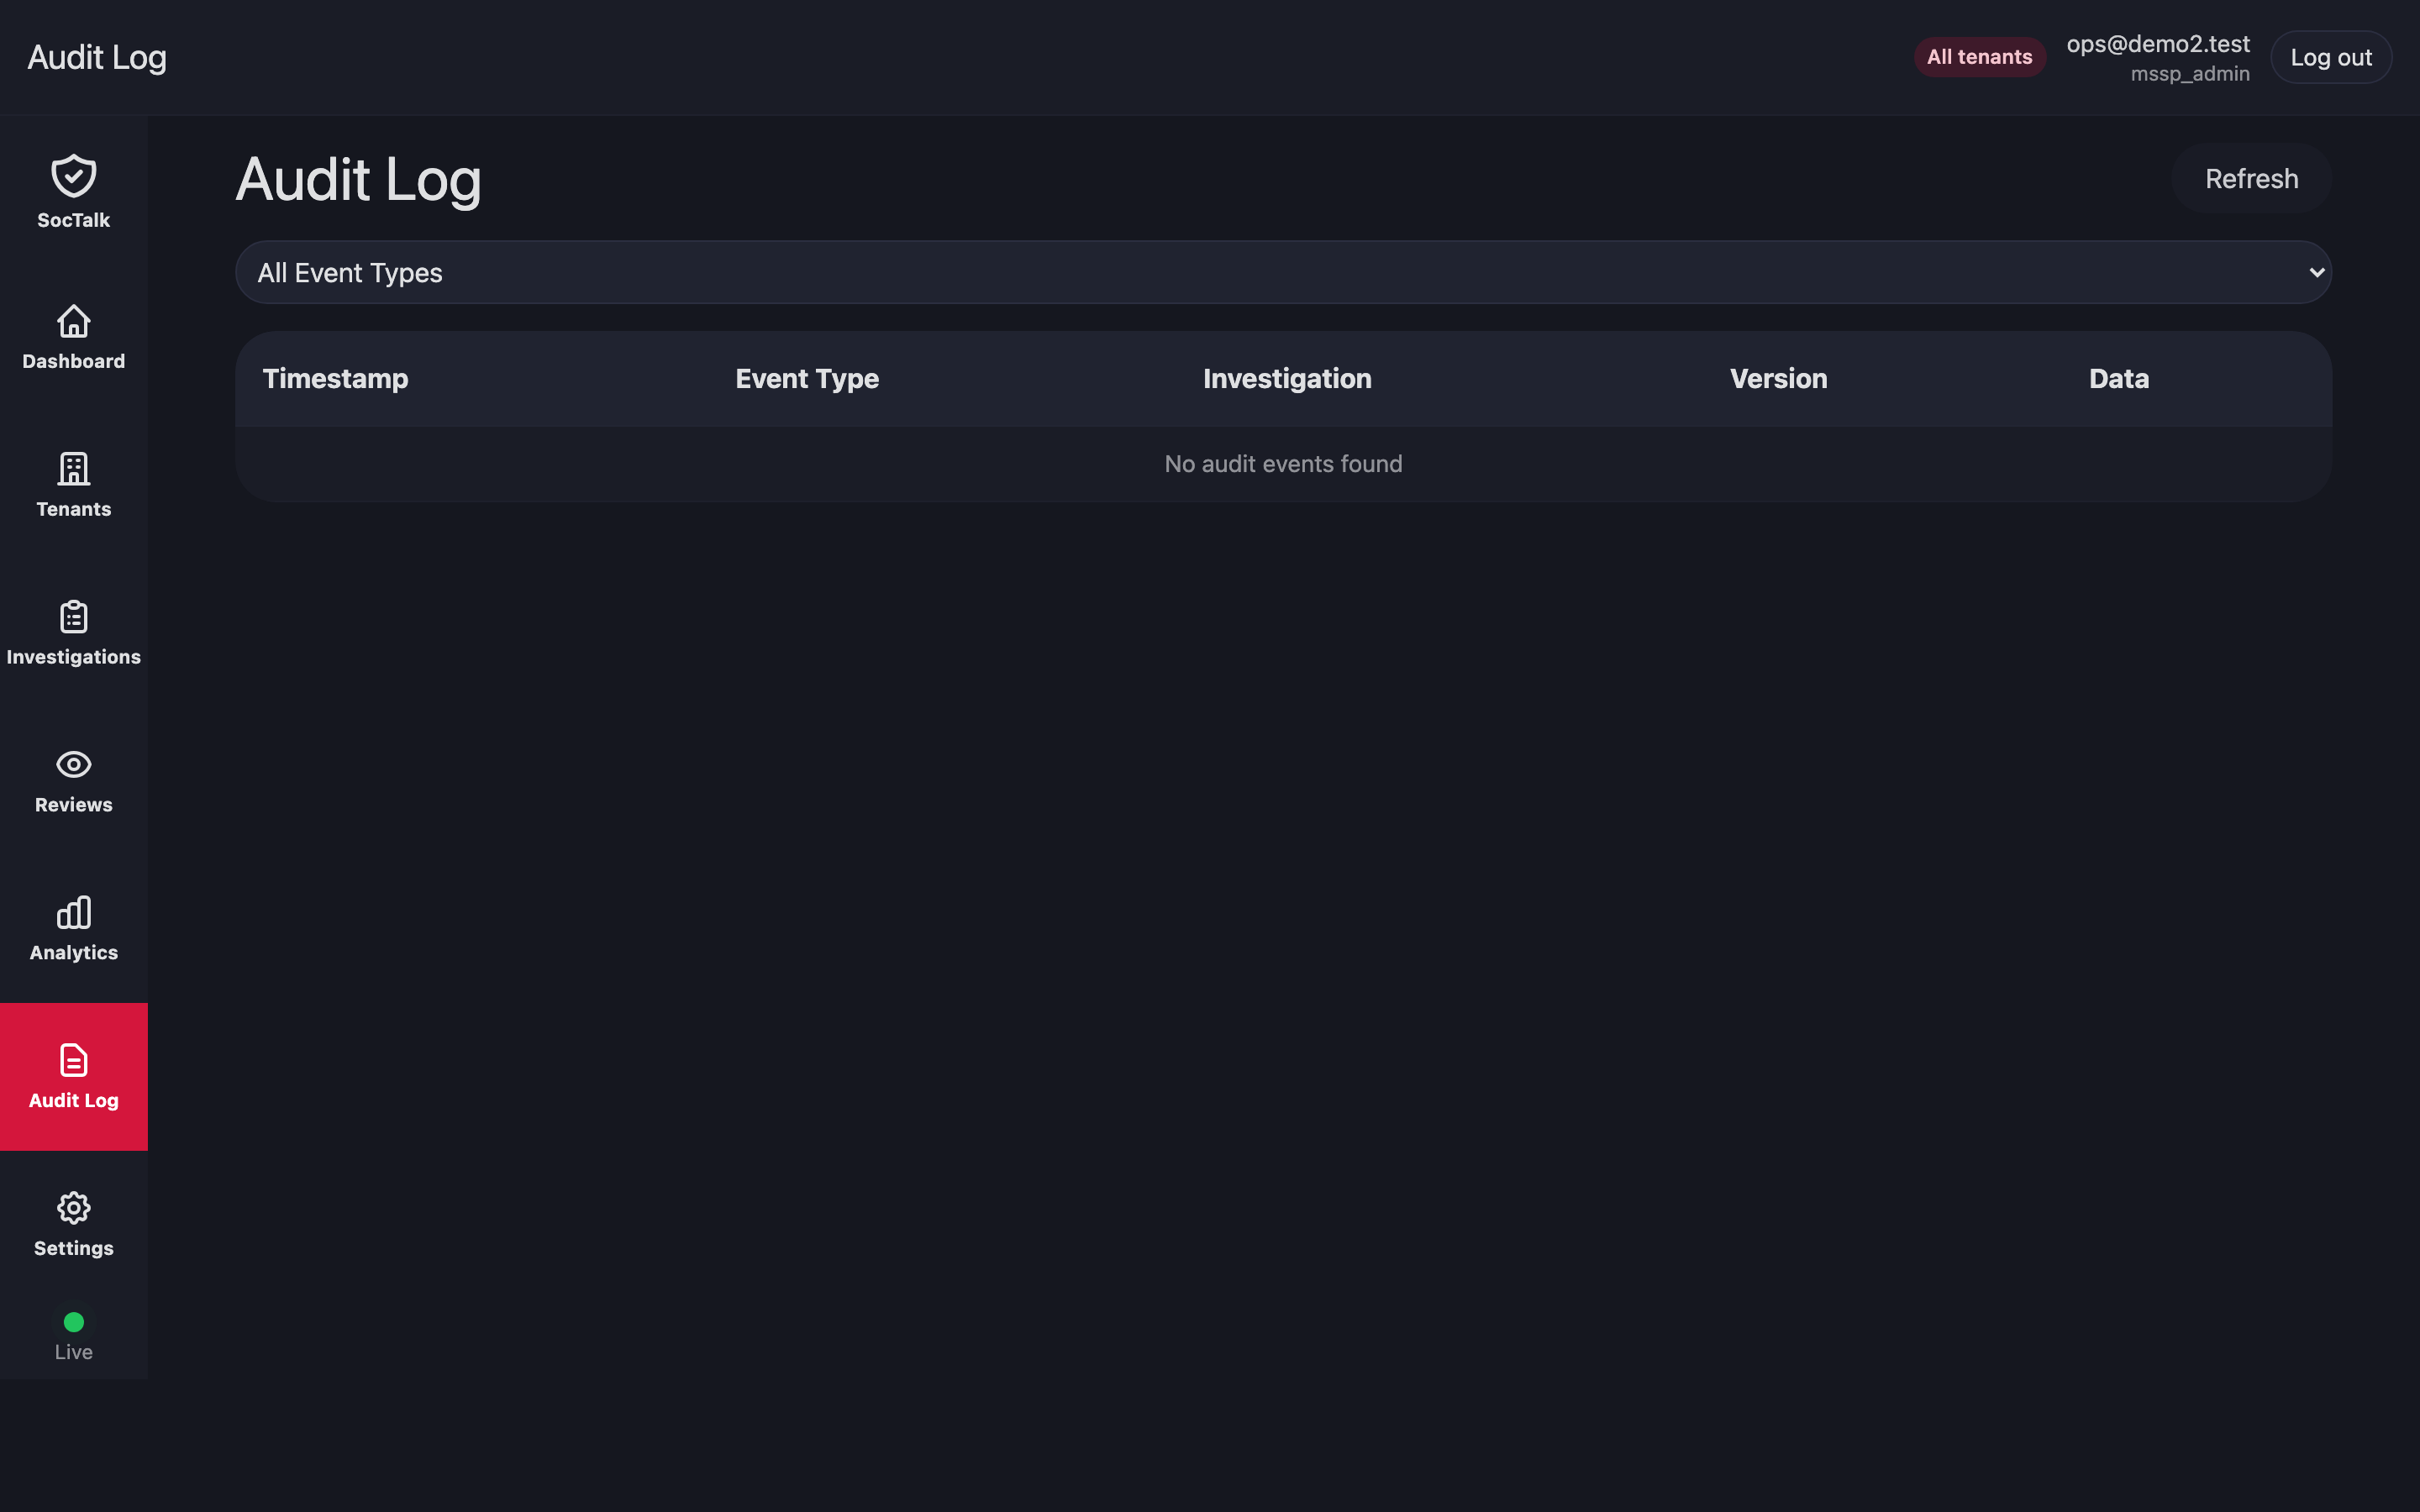
Restauración de la base de datos (recuperación ante desastres)
Los respaldos se gestionan externamente por el MSSP (Velero, snapshots de clúster, pg_dump externo). Para restaurar:
- Detén la API de SocTalk:bash(El chart de V1 empaqueta el orquestador dentro del pod de la API: no hay un Deployment
kubectl -n soctalk-system scale deploy soctalk-system-api --replicas=0soctalk-system-orchestratorseparado.) - Restaura los datos de Postgres desde tu respaldo.
- Reinicia la API:
kubectl -n soctalk-system scale deploy soctalk-system-api --replicas=2(o tu número de réplicas habitual).
Los PVCs del plano de datos del tenant siguen el mismo patrón: restaura por namespace y luego ejecuta helm upgrade sobre el release del tenant para reasociarlos.
Emergencia: deshabilitar un tenant de inmediato
La acción Suspend de la UI en esta versión cambia el estado del tenant a suspended y evita que el orquestador programe nuevas investigaciones, pero no escala las cargas de trabajo. Para un corte real, ejecuta los pasos siguientes (escala todos los deployments + aplica una NetworkPolicy deny-all como medida de seguridad adicional):
# 1. Escala a cero todas las cargas de trabajo del namespace del tenant. Este es
#    el corte definitivo: los pods desaparecen.
kubectl -n tenant-<slug> get deploy,statefulset -o name \
  | xargs -I {} kubectl -n tenant-<slug> scale {} --replicas=0

# 2. deny-all como medida adicional, para que cualquier cosa que vuelva a levantar
#    (por ejemplo, un operador atascado reconciliando) quede aislada.
kubectl -n tenant-<slug> apply -f - <<EOF
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata: { name: emergency-deny-all }
spec:
  podSelector: {}
  policyTypes: [Ingress, Egress]
EOF
Revierte eliminando la NetworkPolicy, escalando las cargas de trabajo de nuevo a su número original de réplicas y llamando Resume en la UI. Resume también solo actualiza el estado en la base de datos en esta versión: no restaurará los números de réplicas por ti.
Sospecha de fuga de datos entre tenants
Si sospechas de acceso entre tenants:
- Revisa las ejecuciones recientes de la suite de pruebas de RLS; pasan en CI en cada versión.
- Sondea la base de datos directamente:bash
kubectl -n soctalk-system exec -it statefulset/soctalk-system-postgres -- \ psql -U soctalk_app -d soctalk \ -c "SET app.current_tenant_id='<tenant-a>'; SELECT tenant_id FROM events LIMIT 5;" - Si se confirma una fuga, abre un incidente P1. RLS más
FORCE ROW LEVEL SECURITYes la última línea de defensa; una fuga sin parchear indica un bug de la aplicación o una mala configuración de rol de Postgres.
Errores comunes
- Ejecutar migraciones como
soctalk_app. Las migraciones necesitan credenciales desoctalk_admin; bajosoctalk_appfallan. - Editar los valores de
soctalk-tenantdirectamente en Helm. Esto evita el estado de base de datos de SocTalk; hazlo a través de la API. - Crear namespaces
tenant-*a mano. Las etiquetas requeridas no estarán presentes y SocTalk no reconocerá el namespace. Usa el flujo de creación de tenants.